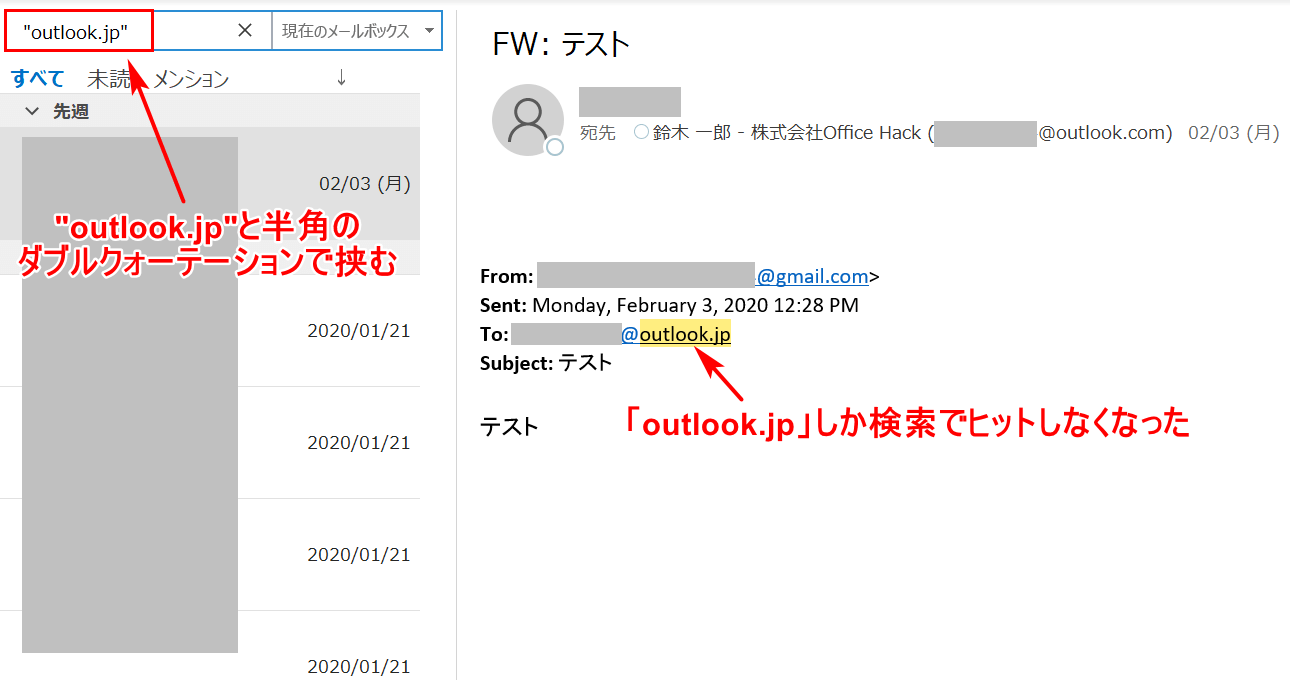
「検索ワードを『"』で囲めばフレーズ全体が完全一致で検索される」という仕様は、多くの検索エンジンにおける標準機能です。しかし、Outlook(特にWindowsデスクトップ版)において「Outlook ダブルクォーテーション 検索 効かない」という悲鳴が後を絶たない背景には、Microsoft SearchおよびWindows Searchが抱える二重の構造的要因が存在します。
第一の要因は、日本語形態素解析による文字列の自動分解です。欧米言語のように単語と単語の間にスペースが入る「わかち書き」言語と異なり、日本語は文や複合語が連続した文字列で構成されます。Outlookの検索インデックスは、入力された日本語をシステム側の辞書に基づいて形態素(意味を持つ最小単位)へと自動分割します。例えば「仕様書改訂案」という単語を「"仕様書改訂案"」と完全一致を意図して囲んで入力しても、インデックス側で「仕様書」「改訂」「案」と分割され、それぞれの単語が近接して含まれるメールや、派生語を含むメールまで広範に拾い上げてしまう現象が発生します。
第二の要因は、デフォルトで組み込まれているプレフィックス検索(前方一致)の強制適用です。Outlookのクイック検索ボックスは、ユーザーが文字を入力している最中から候補を表示するインクリメンタルサーチの思想で作られており、単語の前半部分が合致すればヒットとみなす仕組みが極めて強固に働きます。そのため、特定のプロジェクトコード「AB-1234」をピンポイントで探そうとしても、「AB-12345」や「AB-1234-alpha」といった前方一致の文字列がすべて抽出結果に含まれてしまい、結果として「Outlook 検索 部分一致 除外ができない」というフラストレーションに直結します。
さらに、アンダースコア(_)やハイフン(-)、スラッシュ(/)といった社内コードで頻出する記号が、検索エンジン側で「区切り文字(空白)」として処理されてしまう仕様も拍車をかけています。これらの複合的な挙動こそが、ユーザーが求めている厳格な一致とシステムが提供する検索結果との間に埋めがたい溝を生み出している真相です。

